راهنمای کامل RAG در هوش مصنوعی و وردپرس
در سالهای اخیر، عبارت RAG یا Retrieval-Augmented Generation به یکی از کلیدواژههای اصلی دنیای هوش مصنوعی و بهویژه در حوزه وب و وردپرس تبدیل شده است. مسئله اصلی بسیاری از مدیران سایتها و توسعهدهندگان این است که مدلهای زبانی قدرتمند، مثل ChatGPT، در عین توان بالا، همیشه به دادههای بهروز و اختصاصی سایت آنها دسترسی ندارند و گاهی پاسخهای کلی، غیر دقیق یا حتی نادرست تولید میکنند. RAG دقیقاً برای حل همین مشکل مطرح شده است: ترکیب توان تولید متن مدلهای بزرگ زبانی با قابلیت بازیابی هوشمندانه اطلاعات از پایگاههای داده، اسناد و محتوای اختصاصی سایت. نتیجه این ترکیب، پاسخهایی است که هم از نظر زبانی روان هستند و هم از نظر محتوایی با دادههای واقعی و بهروز شما هماهنگاند.
اگر شما صاحب یک سایت وردپرسی، تولیدکننده محتوا، توسعهدهنده افزونه یا مدیر محصول هستید، احتمالاً با چالشهایی مثل جستجوی ضعیف در سایت، نیاز به چتبات هوشمند، مستندات پیچیده، یا پاسخگویی خودکار اما دقیق به کاربران روبهرو شدهاید. RAG میتواند لایهای هوشمند روی محتوا و دادههای سایت شما بسازد و پاسخهایی ارائه کند که نه فقط بر اساس «حدس» مدل زبانی، بلکه بر اساس «دانش واقعی» موجود در سایت شما تولید شده است. در این مقاله، راهنمایی گامبهگام و کاربردی درباره RAG ارائه میشود: از تعریف و مفاهیم پایه، تا نحوه کار مرحلهبهمرحله، انواع معماریها، مقایسه آنها، کاربردهای عملی در سایتها و وردپرس، مزایا و محدودیتها، نکات طراحی و پیادهسازی، و در نهایت روندهای آینده RAG در هوش مصنوعی وب. هدف این است که در پایان مطالعه، بتوانید تشخیص دهید آیا RAG برای سایت شما مناسب است، چه سناریوهایی را میتوان با آن پیادهسازی کرد و از چه مسیرهایی در اکوسیستم وردپرس به شکل حرفهای آن را اجرا کنید.
در ادامه خواهید خواند:
- RAG چیست و چرا مهم شده است؟
- مفاهیم پایه RAG: بازیابی و تولید
- نحوه کار RAG مرحلهبهمرحله
- انواع معماریهای RAG و مقایسه آنها
- کاربردهای RAG در سایتها و وردپرس
- مزایای کلیدی RAG نسبت به روشهای سنتی
- چالشها، خطرات و محدودیتهای RAG
- بهترین روشها برای طراحی و پیادهسازی RAG
- انتخاب و پیادهسازی RAG در وردپرس
- آینده RAG و روندهای جدید در هوش مصنوعی وب
RAG چیست و چرا مهم شده است؟
تعریف RAG و جایگاه آن
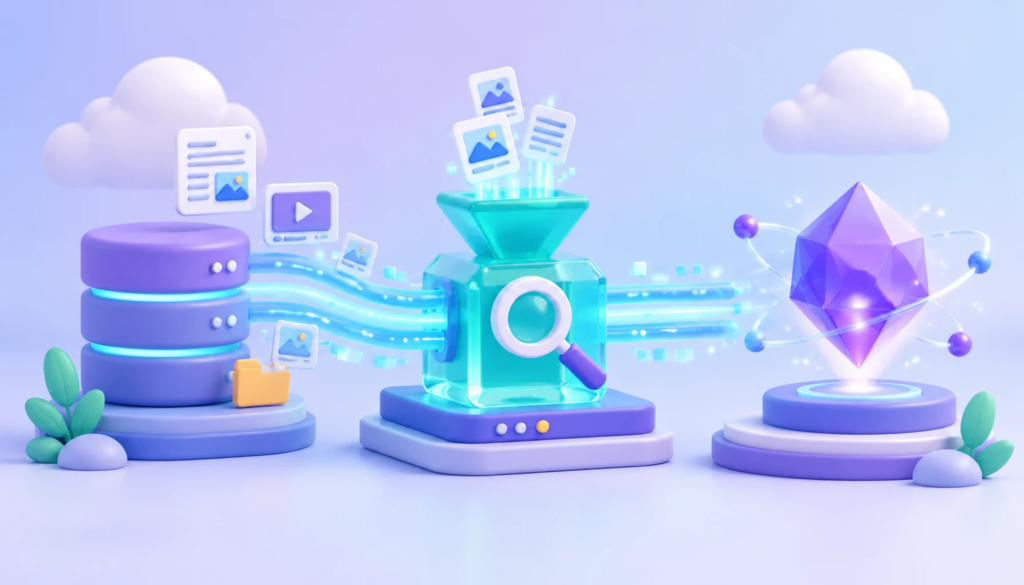
RAG یا Retrieval-Augmented Generation به معماریای در هوش مصنوعی گفته میشود که در آن یک مدل زبانی بزرگ (Large Language Model) هنگام تولید متن، از یک لایه بازیابی اطلاعات کمک میگیرد. به بیان ساده، RAG ترکیبی از دو توانمندی است: درک و تولید متن توسط مدل زبانی، و جستجو و بازیابی دادههای مرتبط از یک منبع خارجی مانند پایگاهداده، فایلها یا محتوای سایت.
در معماری RAG به جای اینکه مدل فقط بر اساس دانش عمومی و دادههای آموزشی اولیه پاسخ بدهد، ابتدا درباره سؤال کاربر در منابع اختصاصی شما (مثلاً محتوای سایت، مستندات، فایلهای PDF یا پایگاهدانش) جستجو میکند، سپس با استفاده از اطلاعات بازیابیشده، پاسخ نهایی را تولید میکند. این رویکرد، RAG را در لایه کاربردی هوش مصنوعی وب در کنار مفاهیمی مثل چتباتهای هوشمند، سیستمهای توصیهگر و موتورهای جستجوی پیشرفته قرار میدهد.
از نظر جایگاه، RAG در مرز بین مدلهای زبانی عمومی (مانند ChatGPT) و راهحلهای اختصاصی سازمانی قرار دارد؛ یعنی میتواند دانش عمومی مدل را با دانش اختصاصی و بهروز وبسایت یا کسبوکار ترکیب کند و پاسخهایی تولید کند که هم از نظر زبانی قوی است و هم از نظر محتوایی متناسب با دادههای شما.
تفاوت RAG با چتباتهای معمول
چتباتهای معمول که صرفاً بر پایه یک مدل زبانی کار میکنند، معمولاً به دادههای آموزش اولیه خود محدود هستند و به محتوای سایت یا پایگاهداده شما دسترسی مستقیم ندارند. نتیجه این محدودیت، پاسخهای کلی، گاهی غیر دقیق و در برخی موارد «ساختهشده» بر اساس حدس مدل است که به آن توهم مدل یا hallucination گفته میشود.
در مقابل، در معماری RAG دو تفاوت اساسی وجود دارد:
اتصال به منبع داده اختصاصی: سیستم RAG قبل از تولید پاسخ، در یک یا چند منبع داده (مانند دیتابیس، فایلها، ایندکس جستجو یا مخزن بردارها) جستجو میکند و بخشهای مرتبط را استخراج میکند.
پاسخ مبتنی بر شواهد: مدل زبانی متن را بر اساس همین اطلاعات بازیابیشده تولید میکند؛ یعنی پاسخ نه فقط «بر پایه حافظه مدل»، بلکه بر پایه شواهد موجود در دادههای شما است.
به همین دلیل، یک چتبات مبتنی بر RAG میتواند:
- به سؤالات بسیار خاص درباره محصولات، خدمات، مستندات فنی یا محتوای آموزشی سایت پاسخ بدهد.
- همگام با بهروزرسانیهای سایت شما، بلافاصله دانش خود را بهروز کند، بدون نیاز به آموزش مجدد کامل مدل.
- ریسک پاسخهای نادرست و غیر قابل استناد را کاهش دهد، زیرا پاسخها در حد امکان به متنهای واقعی موجود در منابع شما تکیه میکنند.
بنابراین تفاوت اصلی RAG با چتباتهای معمول در این است که چتبات کلاسیک بیشتر «حدس میزند»، در حالیکه سیستم RAG ابتدا «جستجو میکند» و سپس «تولید» را انجام میدهد.
چرا RAG برای وردپرس جذاب است
وردپرس به عنوان یک سیستم مدیریت محتوا، معمولاً میزبان حجم زیادی از دادهها است: نوشتهها، برگهها، محصولات فروشگاهی، مستندات، پایگاهدانش، محتوای آموزشی و … . در بسیاری از سایتها، کاربران به دنبال پاسخهای دقیق و سریع درباره همین دادهها هستند؛ اما جستجوی سنتی وردپرس و چتباتهای عمومی، نمیتوانند این نیاز را بهصورت هوشمند و متکی بر محتوای سایت برآورده کنند.
RAG برای وردپرس جذاب است زیرا میتواند نقش لایه هوش مصنوعی متصل به دیتابیس سایت را بازی کند. برخی نقاط قوت آن در اکوسیستم وردپرس عبارتاند از:
پشتیبانی هوشمند برای کاربران: ایجاد چتباتی که به سؤالات کاربران درباره دورهها، محصولات، راهنماها و مقالات پاسخ بدهد و پاسخ را بر اساس محتوای واقعی سایت تولید کند.
مستندسازی پویا: تبدیل مجموعهای از مقالات و مستندات فنی به یک «یار کمکی هوشمند» که بتواند به پرسشهای پیچیده پاسخ تحلیلی بدهد.
کاهش فشار روی پشتیبانی انسانی: در سایتهای پرترافیک، بخش بزرگی از سؤالات تکراری و اطلاعاتی میتواند توسط سیستم RAG پاسخ داده شود و تیم پشتیبانی روی مسائل پیچیدهتر تمرکز کند.
یکپارچگی با افزونهها و دادههای ساختیافته: در وردپرس، دادههای افزونههایی مثل فروشگاه، انجمن، عضویت و آموزش آنلاین، به صورت ساختیافته ذخیره میشوند. با RAG میتوان این دادهها را وارد فرآیند بازیابی کرد و پاسخهایی تولید کرد که دقیقاً روی خروجی همین افزونهها تکیه دارد.
در نهایت، اهمیت RAG در وردپرس از اینجا ناشی میشود که یک سایت میتواند بدون ساخت مدل اختصاصی و بدون زیرساخت پیچیده، از هوش مصنوعی متنی سطح بالا بهرهبرداری کند؛ به شرط آنکه اتصال مناسب بین مدل زبانی و محتوای سایت با معماری RAG پیادهسازی شده باشد. همین ترکیب است که RAG را به یکی از مهمترین رویکردها برای هوش مصنوعی در وب و بهویژه در سایتهای وردپرسی تبدیل کرده است.
مفاهیم پایه RAG: بازیابی و تولید
در معماری RAG، دو جزء اصلی وجود دارد: بازیابی (Retrieval) و تولید (Generation). درک درست این دو بخش و رابطه میان آنها، برای طراحی هر سیستم مبتنی بر RAG، از جمله در وردپرس، ضروری است. بهصورت خلاصه، بخش بازیابی مسئول پیدا کردن اطلاعات مرتبط از پایگاه دانش سایت است و بخش تولید، با استفاده از این اطلاعات و توان مدل زبانی، پاسخ نهایی را میسازد.
بخش بازیابی در RAG چگونه کار میکند
بخش بازیابی در RAG وظیفه دارد از بین حجم زیادی از دادهها، اطلاعات مرتبط با پرسش کاربر را پیدا کند. این دادهها میتواند شامل مقالات سایت، مستندات محصولات، محتوای دورهها، تیکتهای پشتیبانی یا هر نوع متن دیگری باشد که قبلاً ایندکس شده است.
در یک پیادهسازی استاندارد RAG، مسیر بازیابی معمولاً این مراحل را طی میکند:
تبدیل پرسش کاربر به نمایش برداری: پرسش کاربر توسط ماژول امبدینگ (Embedding Model) به یک بردار عددی تبدیل میشود که معنای متن را در فضایی چندبعدی نمایش میدهد.
جستوجو در پایگاه برداری: این بردار پرسش، با بردارهای متونی که قبلاً از محتوای سایت ساخته و در یک پایگاه داده برداری (Vector Database) ذخیره شدهاند، مقایسه میشود تا نزدیکترین نتایج پیدا شوند.
انتخاب قطعههای متن (Context): چند بخش از محتوا که بیشترین شباهت معنایی را به پرسش دارند، به صورت قطعههای متن (chunks) انتخاب و برای مرحله تولید آماده میشوند.
در وردپرس، این بخش میتواند روی انواع محتوا اعمال شود؛ برای مثال:
- نوشتهها و برگهها به صورت متن خردشده و بردارسازی شوند.
- توضیحات محصولات فروشگاه و نقد و بررسیها وارد پایگاه برداری شوند.
- محتوای دورههای آموزشی، دروس و سرفصلها برای بازیابی دقیقتر تنظیم شوند.
نکته مهم در بخش بازیابی این است که کیفیت پاسخ نهایی، شدیداً به کیفیت دادههای ایندکسشده و تنظیمات بازیابی وابسته است؛ از جمله نحوه خرد کردن متن، تعداد نتایج بازیابیشده و فیلترهای اعمالشده (مثلاً محدود کردن به یک دسته خاص).
بخش تولید مبتنی بر مدل زبانی
بخش تولید در RAG مبتنی بر یک مدل زبانی بزرگ (Large Language Model – LLM) است. این مدل، مانند ChatGPT یا سایر مدلهای مشابه، توانایی درک متن و تولید پاسخهای طبیعی را دارد. تفاوت RAG با استفاده ساده از مدل زبانی این است که مدل، به جای اتکا به دانش عمومی درونمدل، از دادههای بازیابیشده سایت به عنوان زمینه استفاده میکند.
فرآیند تولید در RAG معمولاً به این شکل عمل میکند:
ساخت Prompt ترکیبی: پرسش کاربر همراه با متنهای بازیابیشده، در قالب یک دستور ورودی (prompt) به مدل زبانی ارسال میشود. در این مرحله میتوان دستورهای کنترلی اضافه کرد؛ مثل «فقط بر اساس متنهای بالا پاسخ بده» یا «در صورت نبود اطلاعات کافی، اعلام کن که پاسخ در دادههای سایت موجود نیست».
تحلیل زمینه توسط مدل: مدل زبانی متنهای زمینه را میخواند، بخشهای مرتبط را استخراج و ساختار منطقی پاسخ را شکل میدهد.
تولید پاسخ نهایی: خروجی مدل، یک متن منسجم و انسانی است که به پرسش کاربر پاسخ میدهد و به اطلاعات بازیابیشده ارجاع ضمنی دارد؛ بدون آنکه نیاز باشد کاربر خود این متنها را بخواند و ترکیب کند.
در سایت وردپرسی، این پاسخ تولیدشده میتواند بهصورت پیام چت، باکس پاسخ زیر جستوجو، راهنمای هوشمند در صفحه محصول یا مقاله راهنما نمایش داده شود. نکته کلیدی در بخش تولید این است که مدل زبانی باید بهطور واضح محدود و هدایت شود تا از حدسهای خارج از دادههای سایت (Hallucination) تا حد ممکن جلوگیری شود.
نقش بردارها و امبدینگها در RAG
بردارها (Vectors) و امبدینگها (Embeddings) ستون فقرات بخش بازیابی در RAG هستند. امبدینگ در هوش مصنوعی به فرآیندی گفته میشود که طی آن متن، تصویر یا هر نوع داده دیگر به یک بردار عددی با ابعاد ثابت تبدیل میشود؛ بهگونهای که نزدیکی این بردارها، نشاندهنده نزدیکی معنایی دادهها باشد.
در معماری RAG، این مفهوم چند کاربرد حیاتی دارد:
نمایش معنایی متن: به جای جستوجوی صرفاً کلیدواژهای، هر جمله یا پاراگراف از محتوای سایت به صورت بردار ذخیره میشود. این کار امکان جستوجوی معنایی را فراهم میکند؛ یعنی حتی اگر کاربر از واژههای متفاوت استفاده کند، سیستم میتواند مفهوم نزدیک را پیدا کند.
مقایسه پرسش کاربر با محتوای سایت: پرسش کاربر نیز به بردار تبدیل میشود. سپس با استفاده از معیارهایی مثل فاصله کساین (Cosine Similarity)، شباهت این بردار با بردارهای ذخیرهشده محاسبه و نزدیکترینها انتخاب میشود.
ساخت پایگاه داده برداری: برای عملکرد پایدار و سریع، همه امبدینگهای محتوای سایت در یک پایگاه داده برداری تخصصی ذخیره میشوند. این پایگاه داده میتواند سرویس خارجی یا ماژولی درون افزونه وردپرس باشد که عملیات جستوجوی برداری را مدیریت میکند.
در یک سناریوی وردپرسی، روند کار معمولاً اینگونه است:
- افزونه RAG محتوای نوشتهها، محصولات یا دورهها را دورهای یا در لحظه استخراج میکند.
- برای هر بخش محتوا، امبدینگ ساخته و در پایگاه برداری ذخیره میشود.
- در زمان پرسش کاربر، پرسش امبدینگ شده و نزدیکترین بردارها (بخشهای محتوا) بازیابی میشوند.
- این بخشها به مدل زبانی ارسال و پاسخ نهایی تولید میشود.
به این ترتیب، بردارها و امبدینگها نقش پل ارتباطی میان متن خام سایت و قابلیتهای مدل زبانی را بازی میکنند. بدون این لایه برداری، سیستم RAG عملاً نمیتواند جستوجوی معنایی دقیق و مقیاسپذیر روی دادههای وردپرس انجام دهد و مزیت اصلی خود را از دست میدهد.
نحوه کار RAG مرحلهبهمرحله
جریان کامل از پرسش تا پاسخ
در یک سیستم RAG، مسیر اصلی از زمانی شروع میشود که کاربر پرسشی مطرح میکند و تا تولید پاسخ نهایی ادامه مییابد. این جریان را میتوان به چند مرحله متوالی تقسیم کرد که هر کدام نقش مشخصی در دقت و کیفیت پاسخ دارند.
دریافت پرسش کاربر
کاربر یک سؤال متنی وارد میکند؛ برای مثال: «این افزونه از چه نسخهای از وردپرس پشتیبانی میکند؟».
سیستم ابتدا این متن را به عنوان ورودی خام دریافت میکند، بدون هیچ دانش زمینهای نسبت به محتوای سایت.
پیشپردازش و تبدیل پرسش به امبدینگ
متن پرسش توسط یک مدل امبدینگ (Embedding Model) به یک بردار عددی تبدیل میشود. این بردار نماینده معنایی سؤال است؛ یعنی شباهت آن با بردار بخشهای مختلف محتوا، نشاندهنده نزدیکی معنایی آنها است.
بازیابی اسناد مرتبط از پایگاه برداری
امبدینگ پرسش در پایگاه داده برداری (Vector Store) جستوجو میشود. سیستم، نزدیکترین بردارها را بر اساس معیارهایی مثل Cosine Similarity پیدا میکند. نتیجه این مرحله چند بخش متن (چانک) است که از نظر معنایی به سؤال کاربر نزدیک هستند؛ مثل بخشهایی از مستندات افزونه یا صفحه سوالات متداول.
انتخاب و مرتبسازی نهایی متون بازیابیشده
بسته به پیادهسازی، ممکن است یک مرحله بازچینش</strong (Re-ranking) انجام شود. در این مرحله، چند سند برتر دوباره ارزیابی و بر اساس میزان ارتباط واقعی با پرسش مرتب میشوند تا فقط مرتبطترین بخشها به مدل زبانی ارسال شوند.
ترکیب پرسش با متون بازیابیشده و ساخت پرامپت
پرسش اولیه کاربر همراه با متنهای بازیابیشده، در قالب یک پرامپت ساختیافته به مدل زبانی (LLM) ارسال میشود. این پرامپت معمولاً شامل دستورالعمل، متنهای بازیابیشده، و خود پرسش است.
تولید پاسخ توسط مدل زبانی
مدل زبانی با استفاده از متون بازیابیشده و پرسش، پاسخ نهایی را تولید میکند؛ پاسخ باید هم با پرسش سازگار باشد و هم فقط بر مبنای اطلاعات موجود در متون بازیابیشده شکل بگیرد.
پسپردازش و نمایش پاسخ
پاسخ تولیدشده میتواند قبل از نمایش، کمی اصلاح شود؛ برای مثال کوتاهسازی، افزودن لینک به صفحات مرتبط در وردپرس یا اعمال فیلترهای محتوایی. سپس پاسخ در رابط کاربری (چتبات، فرم پشتیبانی یا ویجت سایت) به کاربر نمایش داده میشود.
نحوه آمادهسازی و شاخصگذاری دادهها
برای اینکه مراحل فوق به درستی انجام شوند، لازم است دادهها قبل از هر چیز بهصورت مناسب آماده و شاخصگذاری شوند. این بخش، در عمل زیرساخت عملکرد صحیح یک سیستم RAG را تشکیل میدهد.
استخراج دادهها از منابع مختلف
محتوای سایت، مستندات، فایلهای PDF، پایگاه دانش، تیکتهای پشتیبانی و… باید شناسایی و استخراج شوند. در وردپرس، این دادهها میتوانند شامل نوشتهها، برگهها، محصولات ووکامرس، دورههای آموزشی و مستندات افزونهها باشند.
پاکسازی و استانداردسازی متن
دادهها باید از عناصر غیرضروری مثل کدهای HTML اضافی، منوها، تبلیغات و متنهای تکراری پاک شوند. محتوای نهایی باید تا حد امکان متن خالص و قابل فهم باشد تا مدل امبدینگ بتواند نمایه معنایی مناسبی از آن بسازد.
تقسیم محتوا به چانکهای منطقی
متنها معمولاً به بخشهای کوچکتر (Chunk) تقسیم میشوند. هر چانک میتواند یک پاراگراف، یک زیرعنوان یا بخش مشخصی از محتوا باشد. انتخاب اندازه و ساختار چانک اهمیت زیادی دارد؛ چانکهای بسیار طولانی پیدا کردن بخش دقیق اطلاعات را دشوار میکنند و چانکهای بسیار کوتاه ممکن است زمینه کافی را از دست بدهند.
ساخت امبدینگ برای هر چانک
برای هر چانک، یک بردار امبدینگ ساخته میشود. این کار میتواند از طریق یک سرویس ابری یا یک مدل محلی انجام شود. در این مرحله معمولاً متای اضافی هم ذخیره میشود؛ مثل شناسه نوشته، عنوان، نوع محتوا (نوشته، محصول، مستندات)، زبان و تاریخ بهروزرسانی.
ذخیره در پایگاه داده برداری و شاخصگذاری
امبدینگها در یک پایگاه برداری که از جستوجوی برداری سریع پشتیبانی میکند ذخیره میشوند. این پایگاه میتواند یک سرویس خارجی یا یک موتور جستوجوی برداری داخلی باشد. در اینجا شاخصگذاری برداری انجام میشود تا جستوجو بر اساس شباهت معنایی با کارایی بالا انجام شود.
بهروزرسانی دورهای امبدینگها
هر زمان که محتوای سایت تغییر کند، باید امبدینگها بهروزرسانی شوند. در یک محیط وردپرسی پویا، این روند معمولاً به صورت زمانبندیشده (cron) یا رویدادمحور (پس از انتشار یا ویرایش محتوا) انجام میشود تا پایگاه برداری همیشه تازه باشد.
نقش پرامپت در ترکیب متن بازیابیشده
پرامپت (Prompt) در RAG همان نقطه اتصال بین پرسش کاربر و متنهای بازیابیشده با مدل زبانی است. اگر پرامپت به درستی طراحی نشود، حتی با بهترین دادهها و امبدینگها نیز خروجی مدل میتواند ناقص، مبهم یا نادرست باشد.
یکپارچهسازی پرسش و مدارک بازیابیشده
پرامپت باید پرسش کاربر را به صورت واضح بیان کند و در کنار آن، متنهای بازیابیشده را به شکل قابل خواندن برای مدل قرار دهد. معمولاً ساختار پرامپت شامل بخشهایی مثل «دستورالعمل»، «مدارک» و «پرسش» است.
هدایت مدل برای استفاده از دادههای بازیابیشده
در پرامپت، به مدل زبانی صریحاً گفته میشود که فقط بر اساس مدارک ارائهشده پاسخ دهد و از حدس زدن بدون اتکا به این مدارک پرهیز کند. این نکته برای کاهش Hallucination (تولید اطلاعات ساختگی) اهمیت زیادی دارد.
سازگار کردن لحن و قالب پاسخ
پرامپت میتواند شامل دستورالعملهای مربوط به لحن، طول
انواع معماریهای RAG و مقایسه آنها
RAG ساده در برابر RAG چندمرحلهای
در سادهترین شکل، RAG ساده (Simple RAG) تنها از یک چرخه بازیابی و تولید استفاده میکند. کاربر پرسش را ارسال میکند، سیستم بر اساس امبدینگها (Embeddings) چند سند مرتبط را از پایگاه دانش بازیابی میکند و همان لحظه آنها را به مدل زبانی LLM میدهد تا پاسخ تولید شود. این معماری برای سناریوهایی مانند پشتیبانی معمولی کاربران، پاسخ به سوالات متداول و جستجوی متنی ساده در سایت مناسب است.
در مقابل، RAG چندمرحلهای (Multi-step / Multi-hop RAG) چند لایه بازیابی و پردازش دارد. سیستم ابتدا پرسش را تحلیل میکند، در یک مرحله اولیه، اسناد کلی را پیدا میکند، سپس با توجه به آنها، پرسش را اصلاح یا دقیقتر میکند و در مرحله بعد، اسناد دقیقتری را بازیابی میکند. در بعضی معماریها، یک لایه استدلال میانی وجود دارد که بین هر دو مرحله بازیابی قرار میگیرد و تصمیم میگیرد در گام بعدی چه چیزی باید جستجو شود.
تفاوت کلیدی این دو معماری در سطح پیچیدگی و عمق استدلال است. RAG ساده برای پرسشهای کوتاه و مستقیم مناسب است؛ اما در سوالات تحلیلی، چندبخشی یا سناریوهای پیچیده (مثلاً ترکیب اطلاعات از چند سند مختلف) معمولا دقت کافی ندارد. در RAG چندمرحلهای، هر مرحله میتواند پرسش یا مدارک را پالایش کند و در نتیجه پاسخ نهایی دقیقتر، مستندتر و قابل اعتمادتر میشود؛ البته به بهای هزینه محاسباتی بیشتر و تاخیر بالاتر.
در پیادهسازی روی وبسایتها و بهخصوص وردپرس، معمولا RAG ساده برای چتباتهای عمومی و جستجوی هوشمند کفایت میکند؛ اما اگر سایت شما محتوای تخصصی یا مستندات پیچیده (مانند داکیومنت افزونهها، دورههای آموزشی چندسطحی یا مستندات فنی) دارد، معماری RAG چندمرحلهای میتواند تفاوت ملموسی در کیفیت پاسخها ایجاد کند.
منابع داده داخلی در برابر خارجی
در معماری RAG، منابع داده به طور کلی به دو دسته منابع داخلی (Internal Data Sources) و منابع خارجی (External Data Sources) تقسیم میشوند. انتخاب بین این دو یا ترکیب آنها، هم بر کیفیت پاسخ و هم بر امنیت و حریم خصوصی تاثیر مستقیم دارد.
منابع داخلی شامل تمام دادههای هستند که مستقیما تحت کنترل مالک سایت قرار دارند؛ مثل:
- محتوای نوشتهها و برگههای وردپرس
- مستندات محصول، فایلهای راهنما و FAQ
- پایگاه دانش داخلی سازمان یا فروشگاه
- فایلهای PDF، Word و مستندات آپلود شده در سایت
در معماری RAG مبتنی بر منابع داخلی، تمام متنها پیشپردازش، تکهتکه (Chunking) و سپس امبدینگ و در یک پایگاه برداری (Vector Database) ذخیره میشوند. این روش برای سیستمهای پشتیبانی اختصاصی، سایتهای آموزشی و سرویسهای B2B که محتوای آنها خاص و محرمانه است، مناسبتر است؛ زیرا کنترل کامل روی دادهها وجود دارد و احتمال نشت اطلاعات حساس کاهش پیدا میکند.
در سمت دیگر، منابع خارجی شامل سرویسها و دادههایی است که خارج از سایت قرار دارند؛ مانند:
- موتورهای جستجوی وب و APIهای جستجو
- سرویسهای مستندات آنلاین (مثلاً مستند رسمی یک API)
- پایگاههای دانش عمومی، انجمنها و مستندات متنباز
RAG مبتنی بر منابع خارجی معمولا برای سناریوهایی به کار میرود که پاسخ باید از دانش عمومی و بهروز استخراج شود؛ مثلا پاسخ به سوالات درباره بهروزرسانیهای جدید یک فریمورک یا خبرها و تغییرات قوانین. مزیت این رویکرد، گستره وسیع اطلاعات است؛ اما چالشهایی مثل وابستگی به سرویسهای دیگر، تاخیر بیشتر، ریسک محتوای نادرست و مدیریت حریم خصوصی کاربران را نیز به همراه دارد.
در عمل، بسیاری از معماریهای حرفهای از رویکرد ترکیبی استفاده میکنند: ابتدا تلاش میکنند از پایگاه دانش داخلی پاسخ پیدا کنند و فقط اگر پاسخ مناسب یافت نشد، به سراغ منابع خارجی میروند. برای سایتهای وردپرسی، این مدل ترکیبی میتواند تعادل مناسبی بین دقت، کنترل و پوشش اطلاعات ایجاد کند.
مقایسه RAG با فاینتیونینگ مدلها
یکی از سوالات رایج در طراحی معماری هوش مصنوعی این است که: چه زمانی باید از RAG استفاده کرد و چه زمانی از فاینتیونینگ (Fine-tuning)؟ این دو رویکرد هر دو با هدف تطبیق مدل با نیازهای خاص شما به کار میروند، اما معماری و پیامدهای متفاوتی دارند.
در فاینتیونینگ، شما مدل زبانی پایه را با دادههای خاص خود دوباره آموزش میدهید تا مدل دانش و سبک جدید را در پارامترهای خودش یاد بگیرد. این کار برای سناریوهایی مانند:
- آموزش مدل به زبان تخصصی یک صنعت (مثلا پزشکی، حقوقی)
- هماهنگ کردن لحن پاسخها با برند
- آموزش مدل برای وظایف ساختاری خاص (مثل طبقهبندی اسناد، استخراج فیلدها)
بسیار موثر است. اما فاینتیونینگ معمولا هزینهبر است، به زیرساخت مناسب و دادههای پاکسازی شده نیاز دارد و به شکل مستقیم پاسخ را به آخرین نسخه محتوای سایت شما وصل نمیکند.
در مقابل، معماری RAG دانش را در خود مدل تزریق نمیکند، بلکه از مدل به عنوان یک موتور استدلال و زبان استفاده میکند که روی اسناد بازیابی شده از پایگاه دانش شما کار میکند. پیامد اصلی این رویکرد:
- بهروزرسانی دانش بسیار سریعتر است؛ کافی است پایگاه دانش را بهروزرسانی کنید.
- برای هر سایت یا مشتری جدید لازم نیست مدل جدید فاینتیون شود.
- خطر نشت دانش محرمانه در پارامترهای مدل کمتر است، چون داده در خود مدل ذخیره نمیشود.
برای سایتهای وردپرسی و
کاربردهای RAG در سایتها و وردپرس
در وبسایتهای مدرن، بهویژه سایتهای وردپرسی، حجم محتوا هر روز بزرگتر و متنوعتر میشود. معماری RAG این امکان را فراهم میکند که مدلهای زبانی بزرگ را مستقیما به محتوای اختصاصی سایت و دادههای داخلی وصل کنیم و از هوش مصنوعی، یک دستیار آگاه به محتوای سایت بسازیم. در ادامه، چند سناریوی عملی و رایج در وبسایتها و افزونههای وردپرس را بررسی میکنیم.
پاسخگو به محتوای اختصاصی سایت
یکی از رایجترین کاربردهای RAG در وبسایتها، ایجاد سیستم پرسش و پاسخ مبتنی بر محتوای اختصاصی است. در این سناریو، کاربر سؤال خود را در سایت مطرح میکند و سیستم، بهجای پاسخ عمومی و کلی، با استفاده از بازیابی و تولید، پاسخی متناسب با محتوای داخلی سایت ارائه میدهد.
در وردپرس، این محتوا میتواند شامل انواع زیر باشد:
- مقالات وبلاگ، خبرها و محتوای آموزشی
- صفحات محصول، توضیحات ویژگیها و جداول مقایسه
- صفحات راهنما، مستندات داخلی و مقالات پایگاه دانش
- محتوای خصوصی مثل مستندات عضویت، دورهها و محتواهای محافظتشده
در یک پیادهسازی متداول، افزونه RAG وردپرس:
- پستها، برگهها، محصولات و مستندات را ایندکس و تبدیل به بردارهای معنایی میکند.
- در زمان سؤال کاربر، مرتبطترین بخشهای محتوا را بازیابی میکند.
- با استفاده از مدل زبانی، پاسخ را از روی همین بخشهای بازیابی شده تولید میکند.
نتیجه این است که کاربر بهجای جستوجوی دستی بین دهها صفحه، پاسخ دقیق را از زبان یک دستیار هوشمند دریافت میکند؛ پاسخی که ریشه در محتوای واقعی سایت دارد و امکان ارجاع به صفحات اصلی نیز در آن وجود دارد.
مستندسازی و پشتیبانی مبتنی بر RAG
کاربرد مهم دیگر RAG در وبسایتها، بهویژه در SaaS، فروشگاههای اینترنتی و سایتهای آموزشی، اتوماسیون پشتیبانی و مستندسازی است. در این الگو، RAG روی مجموعهای از سؤالات متداول (FAQ)، مستندات فنی، تیکتهای گذشته و راهنمای استفاده از محصول آموزش داده نمیشود، بلکه این منابع را در مرحله بازیابی استفاده میکند.
سناریوهای رایج در وردپرس:
بات پشتیبانی ۲۴ ساعته که بهصورت چتبات در سایت قرار میگیرد و براساس پایگاه دانش وردپرس (مقالات، مستندات، تیکتها) پاسخ میدهد.
دستیار درونبرگهای برای صفحات محصول یا دوره که به سؤالات متداول همان صفحه با توجه به محتوا، ویژگیها و نظرات پاسخ میدهد.
سیستم پیشنهاد مقاله که هنگام ارسال تیکت جدید، براساس متن سؤال کاربر، مقالات یا مستندات مرتبط را به صورت خودکار پیشنهاد میکند.
مزیت کلیدی RAG در این سناریو، یکپارچگی با پایگاه دانش است. هر زمان که مقالهای به روز یا صفحه جدیدی در وردپرس اضافه شود، بدون نیاز به آموزش مجدد مدل، سیستم پشتیبانی هوشمند نیز بهروز میشود. این موضوع برای تیمهای پشتیبانی پرمشغله، تفاوت محسوسی در کاهش حجم تیکتها و بهبود سرعت پاسخگویی ایجاد میکند.
شخصیسازی تجربه کاربر با دادههای سایت
RAG فقط برای پاسخگویی متنی به سؤالات عمومی نیست؛ میتوان از آن برای شخصیسازی تجربه کاربر براساس دادههای سایت و رفتار کاربران نیز استفاده کرد. در این سطح، RAG روی پروفایل کاربر، تاریخچه تعامل و محتوای موجود در سایت کار میکند تا توصیهها و پاسخها را برای هر کاربر، متناسب با شرایط او تنظیم کند.
نمونههای عملی در وردپرس:
- در یک سایت آموزشی وردپرس:
- RAG براساس دورههایی که کاربر دیده، آزمونهایی که داده و مقالاتی که مطالعه کرده، مسیر یادگیری شخصی پیشنهاد میکند.
- در یک فروشگاه ووکامرس:
- RAG با ترکیب توضیحات محصولات، نظرات، سفارشهای گذشته و ویژگیهای کاربر، توصیههای خرید متنی و تعاملی ارائه میدهد.
- در یک وبسایت خدماتی:
- براساس فرمهای پر شده، تیکتها و قراردادها، پیشنهادهای متناسب با نیاز کاربر تولید میشود و در قالب گفتوگو یا ایمیل هوشمند نمایش داده میشود.
در این سناریو، معماری RAG روی دادههای داخلی وردپرس (پروفایل کاربران، سفارشها، لاگهای تعامل، فرمها) و محتوای متنی عمومی سایت تکیه میکند. نتیجه این است که هر کاربر احساس میکند با یک دستیار اختصاصی در حال تعامل است که هم محصول و محتوای سایت را میشناسد و هم سابقه و نیاز او را.
مزایای کلیدی RAG نسبت به روشهای سنتی
دقت بیشتر با تکیه بر دادههای واقعی
در معماری RAG یا Retrieval-Augmented Generation، مدل زبان بزرگ (LLM) بهجای اتکا به حافظه عمومی خود، روی محتوای واقعی و بهروز سایت و دادههای داخلی شما تکیه میکند. این رویکرد، نسبت به مدلهای سنتی مبتنی بر دانش عمومی، چند مزیت کلیدی دارد.
کاهش خطا و «توهم» مدل: در روشهای سنتی، مدل ممکن است پاسخهایی تولید کند که ظاهری معتبر دارند اما پشتوانه دادهای ندارند. در RAG، پاسخ بر اساس اسناد بازیابی شده از پایگاه دانش (مثلاً نوشتههای وردپرس، مستندات محصول، تیکتها و…) تولید میشود و این وابستگی، احتمال تولید پاسخ نادرست را کاهش میدهد.
پاسخهای متناسب با حوزه تخصصی سایت: مدل بهجای تکیه بر دانش عمومی، از محتوای اختصاصی برند و سایت شما استفاده میکند. به این ترتیب، پاسخها هم از نظر واژگان و هم از نظر سطح تخصص، با حوزه کاری شما هماهنگ میشوند.
یکپارچگی اطلاعات در کانالهای مختلف: وقتی همان پایگاه دانش در چتبات، جستوجوی هوشمند و پیشنهاددهنده محتوا استفاده میشود، خروجیها هماهنگ و سازگار خواهند بود؛ مزیتی که در سیستمهای سنتی پراکنده و ماژولار کمتر دیده میشود.
در یک سایت وردپرسی، این یعنی پاسخهای هوشمند بر پایه نوشتهها، محصولات، پرسشهای متداول و دادههای کاربر تولید میشوند و دقت کلی تجربه کاربری و اعتماد به سیستم افزایش مییابد.
بهروزرسانی آسان بدون آموزش مجدد مدل
در رویکردهای سنتی، برای اعمال تغییرات مهم در دانش سیستم، معمولاً نیاز به آموزش مجدد یا تنظیم دوباره (fine-tuning) مدل وجود دارد که فرآیندی زمانبر، پرهزینه و پیچیده است. RAG این محدودیت را تا حد زیادی برطرف میکند.
جدا شدن لایه دانش از مدل: در RAG، لایه دانش در قالب پایگاه اسناد ایندکس شده (مثلاً با بردارها یا همان embeddings) نگهداری میشود. هر زمان که محتوا در وردپرس بهروزرسانی شود، تنها کافی است این ایندکس بهروزرسانی شود و نیازی به دستکاری خود مدل نیست.
چابکی در بهروزرسانی محتوا: تغییر قیمتها، شرایط خدمات، راهنماهای محصول یا سیاستهای سایت، فقط با بهروزرسانی نوشتهها و صفحات انجام میشود. سیستم RAG در فراخوانی بعدی، نسخه جدید محتوا را بازیابی و در پاسخ لحاظ میکند.
کاهش هزینه نگهداری: چون مدل پایه ثابت میماند، هزینههای محاسباتی و تخصصی برای آموزش و تنظیم مدل کاهش پیدا میکند و تمرکز اصلی به سمت مدیریت محتوا و بهینهسازی پایگاه دانش میرود.
برای وبسایتهای وردپرسی، این یعنی تیم محتوا و مدیر سایت میتوانند با فرآیندهای آشنا (ویرایش نوشتهها، بهروزرسانی محصولات، مدیریت دستهها و برچسبها) دانش سیستم هوش مصنوعی را بهروزرسانی کنند؛ بدون اینکه وابسته به تیم فنی مدلهای یادگیری عمیق باشند.
کنترل بهتر بر منبع و محتوای پاسخها
یکی از دغدغههای اصلی کسبوکارها در استفاده از مدلهای زبانی، شفاف نبودن منبع پاسخها و عدم کنترل کافی روی محتوای تولیدی است. RAG با افزودن لایه بازیابی، امکان کنترل و نظارت دقیقتر را فراهم میکند.
ردیابی منبع پاسخ: در RAG، هر پاسخ بر اساس مجموعهای از اسناد بازیابی شده تولید میشود. میتوان این اسناد را همراه پاسخ به کاربر نشان داد (مثلاً لینک به نوشته یا محصول) تا مشخص شود پاسخ بر چه مبنایی تولید شده است.
اعمال سیاستهای محتوا: با کنترل روی پایگاه اسناد (مثلاً حذف یا محدود کردن بعضی دستهها، نقشها یا نوع دادهها)، میتوانید تعیین کنید چه نوع اطلاعاتی در پاسخها استفاده شود و چه مواردی بهطور کامل نادیده گرفته شود.
مسئولیتپذیری و تطابق با مقررات: در بسیاری از حوزهها (مالی، حقوقی، پزشکی) لازم است بتوان نشان داد که اطلاعات از منابع معتبر استخراج شدهاند. RAG این امکان را میدهد که پاسخها به اسناد مشخص و قابل مستند ارجاع داده شوند.
در وردپرس، این کنترل میتواند تا سطح نوع پستها، نقشهای کاربری و سطح دسترسی پیش برود؛ بهطور مثال، RAG فقط از نوشتههای عمومی و مستندات تأیید شده استفاده کند و بههیچوجه به پیشنویسها، لاگهای داخلی یا دادههای حساس دسترسی نداشته باشد.
ترکیب این قابلیتها باعث میشود RAG در مقایسه با روشهای سنتی، هم از نظر دقت و بهروز بودن و هم از نظر قابلیت کنترل و انطباق با سیاستهای سازمان، گزینهای مناسبتر برای پیادهسازی هوش مصنوعی در وب و وردپرس باشد.
چالشها، خطرات و محدودیتهای RAG
وابستگی به کیفیت منبع و ایندکس
سامانههای RAG بهطور مستقیم به کیفیت منابع داده و نحوه ایندکسگذاری وابسته هستند. هر نقص در این دو لایه، مستقیماً به خروجی مدل منتقل میشود و حتی قویترین مدل زبانی نیز نمیتواند ضعف داده را جبران کند.
در عمل، اگر محتوای سایت یا مستندات داخلی شما ناقص، قدیمی یا متناقض باشد، RAG نیز خروجی ناقص، قدیمی یا متناقض تولید میکند؛ فقط با ظاهری منسجم و قانعکنندهتر. این مسئله در سایتهای وردپرسی که سالها محتوای پراکنده، دستهبندیهای نامنظم و تگهای نامرتب دارند، شدیدتر است.
چالش دیگر، تنظیم ایندکس برداری (Vector Index) است. انتخاب نادرست:
- مدل برداری (Embedding Model)
- ابعاد بردار
- روش نرمالسازی و پیشپردازش متن
- اندازه chunkها (تقسیم محتوا به قطعات)
میتواند باعث بازیابی متنهای نامرتبط یا بیشازحد کلی شود. در وردپرس، اگر بدون استراتژی، همه نوشتهها، برگهها، دیدگاهها و حتی لاگهای فنی را ایندکس کنید، پرسوجوها به محتوای نامناسب یا نویز زیادی برخورد میکنند.
بهطور خلاصه، RAG بهاندازه زنجیره «محتوا → ایندکس → تنظیمات جستوجو» قابلاعتماد است. هر ضعف در این زنجیره، مستقیماً ریسک خطا در پاسخها را بالا میبرد.
مسائل حریم خصوصی و امنیت دادهها
در معماری RAG، مدل برای پاسخگویی، به اسناد و دادههای شما دسترسی میگیرد؛ همین نقطه، منبع اصلی ریسکهای حریم خصوصی و امنیت است. اگر مرز دادههای عمومی، داخلی و محرمانه بهدرستی تفکیک نشود، احتمال نشت اطلاعات وجود دارد؛ حتی اگر مدل اصلی بسیار قدرتمند و امن باشد.
در محیط وردپرس، چند سناریوی حساس عبارتاند از:
- ایندکس شدن پیشنویسها، نوشتههای خصوصی و لاگهای سیستمی در ایندکس RAG
- ذخیرهسازی دادههای شخصی کاربران (ایمیل، شماره تماس، سفارشها) در پایگاهداده برداری بدون ماسککردن یا حداقلسازی داده
- ارسال متن کامل محتوای حساس به سرویسهای ابری خارجی برای تولید بردار یا پاسخ
چالش اصلی این است که RAG ذاتاً برای ترکیب و بازنویسی محتوا طراحی شده است. درنتیجه اگر دسترسیها و سیاستهای ایندکسگذاری دقیق تنظیم نشوند، مدل میتواند ناخواسته بخشی از دادههای حساس را در پاسخها بازتاب دهد؛ حتی بدون ذکر مستقیم منبع.
برای کاهش ریسک، لازم است:
- سطوح دسترسی نقشهای کاربری در وردپرس، با سطح دسترسی RAG هماهنگ شود.
- دادههای حساس قبل از ورود به ایندکس، حذف، ماسک یا ناشناسسازی شوند.
- در استفاده از APIهای خارجی، سیاستهای ذخیرهسازی و استفاده ثانویه از داده (Data Retention & Reuse) بهدقت بررسی شود.
هالوسینیشن و پاسخهای نادرست در RAG
هالوسینیشن (Hallucination) به تولید پاسخهای ظاهراً منطقی اما نادرست توسط مدل زبانی گفته میشود. RAG برای کاهش هالوسینیشن طراحی شده است، اما آن را بهطور کامل حذف نمیکند. در واقع، اگرچه مدل به اسناد شما ارجاع میگیرد، همچنان بخش مهمی از ترکیب و نتیجهگیری را خود مدل انجام میدهد و همین بخش، محل اصلی خطاست.
نمونههای رایج هالوسینیشن در RAG:
- استنتاج قواعد یا سیاستها از چند سند ناقص و نتیجهگیری اشتباه
- پرکردن شکافهای اطلاعاتی با حدس، بدون اشاره به «عدم قطعیت»
- ترکیب دو منبع ناسازگار و تولید پاسخی یکدست اما نادرست
در وبسایتها و وردپرس، این مشکل زمانی خطرناکتر میشود که پاسخهای RAG در صفحات عمومی، بدون هشدار یا مسئولیتپذیری محدود نمایش داده شوند؛ بهخصوص در حوزههای پزشکی، مالی و حقوقی. کاربر تصور میکند با یک سیستم جستوجوی ساده طرف است که صرفاً از محتوا نقلقول میکند، درحالیکه مدل در حال استنتاج و تولید متن جدید است.
محدودیت دیگر این است که RAG در صورت نبود منبع مرتبط، بهصورت پیشفرض سکوت نمیکند؛ بلکه تمایل به پاسخگویی دارد. اگر در طراحی، مکانیزمهایی مانند:
- آستانه شباهت معنایی برای پذیرش یا رد نتایج بازیابیشده
- الزام مدل به اعلام «عدم وجود اطلاعات کافی» در صورت نبود سند مرتبط
- نمایش منابع استناد در کنار پاسخ
پیشبینی نشود، احتمال تولید پاسخهای نادرست و غیرقابل ردیابی بالا میرود.
در جمعبندی این بخش، باید توجه داشت که RAG ذاتاً معصوم از خطا نیست. این معماری فقط ابزار بهتری برای کنترل و ردیابی پاسخها در اختیار قرار میدهد؛ اما تا زمانی که کیفیت محتوا، طراحی ایندکس، سیاستهای امنیتی و تنظیمات مدل بهصورت حرفهای مدیریت نشود، ریسک خطا، نشت داده و هالوسینیشن همچنان جدی خواهد بود.
بهترین روشها برای طراحی و پیادهسازی RAG
انتخاب مناسب پایگاه برداری و امبدینگ
در معماری RAG، کیفیت کل سیستم به دو مؤلفه کلیدی وابسته است: امبدینگها (Embeddings) و پایگاه برداری (Vector Database). اگر یکی از این دو بخش ضعیف طراحی شود، حتی قدرتمندترین مدل زبانی نیز نمیتواند پاسخهای دقیق تولید کند.
در انتخاب مدل امبدینگ، چند نکته کلیدی وجود دارد:
- همخوانی زبان و دامنه: برای سایتهای فارسیزبان، استفاده از مدلهای امبدینگ بهینهشده برای زبان فارسی یا مدلهای چندزبانه امتیاز محسوب میشود. مدلهای صرفاً انگلیسی در متون فارسی دقت کمتری دارند.
- ثبات نسخه: تغییر مداوم مدل امبدینگ بدون re-indexing باعث ناسازگاری بردارها و افت کیفیت پاسخ میشود. یک نسخه مشخص را انتخاب کنید و روی همان نسخه ایندکس بسازید.
- تعادل بین دقت و هزینه: مدلهای بزرگتر معمولاً امبدینگ دقیقتری تولید میکنند، اما هزینه پردازش و ذخیرهسازی را افزایش میدهند. برای سایتهای وردپرسی با حجم بالای محتوا، انتخاب مدل میانرده با تنظیمات دقیق اغلب گزینه عملیتری است.
در مورد پایگاه برداری، معیارهای زیر اهمیت دارد:
- نوع ایندکس: ساختارهای جستوجوی تقریبی مانند HNSW یا IVF برای حجمهای بالا مناسب هستند. برای سایتهای کوچک میتوان از جستوجوی دقیق (Exact) استفاده کرد تا دقت حداکثری حفظ شود.
- مدیریت نسخه محتوا: هنگام بهروزرسانی یا حذف محتوا، باید بردارها نیز بهروز شوند. داشتن ID یکتا برای هر سند و هر قطعه (chunk) ضروری است.
- فیلترهای متادیتا: در ذخیره هر بردار، میدانهایی مانند نوع محتوا (مقاله، محصول، مستندات)، زبان، دستهبندی، وضعیت انتشار و نقش کاربر هدف را بهعنوان متادیتا (Metadata) ذخیره کنید. این متادیتا در زمان بازیابی، امکان فیلترسازی دقیق را فراهم میکند.
در نهایت، برای وردپرس، توصیه میشود ارتباط بین آیدی نوشته، آیدی کاربر، نقش کاربری و برچسبها با بردارها بهصورت شفاف تعریف شود تا بتوان برای هر سناریو (مانند محتوای عمومی یا محتوای فقط برای اعضا) قوانین جداگانه بازیابی و پاسخگویی تنظیم کرد.
طراحی پرامپت و کنترل جریان پاسخ
یک سیستم RAG بدون پرامپت (Prompt) حرفهای، خروجی پایدار و قابل اطمینانی تولید نمیکند. پرامپت در RAG فقط «سوال کاربر» نیست؛ بلکه شامل دستورالعملهای دقیق به مدل برای نحوه استفاده از نتایج بازیابیشده است.
چند اصل کلیدی در طراحی پرامپت وجود دارد:
- تفکیک نقشها: مدل را بهطور صریح بهعنوان یک «دستیار مبتنی بر اسناد» معرفی کنید و مشخص کنید که فقط بر اساس اسناد بازیابیشده پاسخ بدهد. برای مثال، در پرامپت توضیح داده شود که «اگر اطلاعات کافی در اسناد وجود ندارد، پاسخ را متوقف کن و اعلام کن اطلاعات کافی نیست».
- ساختار مشخص پاسخ: قالب پاسخ را تعریف کنید؛ مثلاً ابتدا خلاصه، سپس جزئیات، و در پایان فهرست منابع. این کار بهخصوص برای استفاده در سایتها و افزونههای وردپرسی، کنترل فرانتاند را سادهتر میکند.
- استفاده از دستورالعملهای منفی: در پرامپت، مدل را ملزم کنید که از انجام کارهایی مانند حدسزدن، اظهار نظر خارج از اسناد، یا ارائه توصیه حقوقی/پزشکی بدون منابع خودداری کند.
در کنار پرامپت، کنترل جریان پاسخ نقش مهمی دارد. چند نکته عملی در این بخش:
- آستانه شباهت: قبل از ارسال نتایج بازیابیشده به مدل، حداقل یک آستانه برای امتیاز شباهت تعریف کنید. اگر هیچ سندی از این آستانه بالاتر نبود، بهجای ارسال دادههای ضعیف، از مدل بخواهید اعلام کند «اطلاعات موجود نیست».
- محدودکردن تعداد اسناد: ارسال تعداد زیاد قطعههای متن (chunks) باعث حواسپرتی مدل و افزایش احتمال هالوسینیشن میشود. معمولاً ۳ تا ۱۰ قطعه مرتبط برای هر پرسش کافی است، به شرطی که مرتبسازی (Ranking) بهدرستی انجام شده باشد.
- پشتیبانی از چند سبک پاسخ: با تعریف پرامپتهای مختلف برای سناریوهای متفاوت (سوال کوتاه، توضیح آموزشی، پاسخ فنی، خلاصهسازی) میتوان خروجی را با نیاز کاربر هماهنگتر کرد. این الگو در افزونههای وردپرسی بهصورت انتخاب قالب پاسخ در پنل تنظیمات پیادهسازی میشود.
ارزیابی کیفیت پاسخها و بهبود مستمر
یک سیستم RAG بدون ارزیابی مداوم بهتدریج کارایی خود را از دست میدهد، زیرا محتوا تغییر میکند، نیاز کاربران عوض میشود و مدلهای زبانی یا امبدینگها بهروزرسانی میشوند. برای حفظ کیفیت، لازم است یک چرخه پایش – ارزیابی – بهبود تعریف شود.
در ارزیابی کیفیت پاسخ، چند شاخص (Metric) کلیدی وجود دارد:
- ارتباط پاسخ با سوال: آیا پاسخ واقعاً پرسش کاربر را پوشش میدهد؟ این مورد را میتوان با بازبینی دستی تعدادی از پاسخها و نیز با سنجش خودکار بر اساس معیارهای معنیمحور (semantic similarity) بررسی کرد.
- صحت محتوایی: آیا پاسخ با اسناد ذخیرهشده و واقعیت دامنه سایت همخوانی دارد؟ وجود تناقض بین پاسخ و مستندات داخلی، نشانه ضعف در طراحی بازیابی یا پرامپت است.
- شفافیت و ارجاع به منابع: پاسخ باید تا حد امکان به منابع اشاره کند؛ مثلاً عنوان مقاله، لینک، یا شناسه محصول. این کار اعتماد کاربر را افزایش میدهد و ردیابی خطا را سادهتر میکند.
برای پیادهسازی بهبود مستمر در محیط وب و وردپرس، میتوان از راهکارهای زیر استفاده کرد:
- ثبت لاگ جلسات گفتگو: هر پرسش و پاسخ، به همراه اسناد بازیابیشده، در یک لاگ ساختاریافته ذخیره شود. این دادهها، پایه تحلیل خطا و بهبود پرامپت، امبدینگ و سیاستهای بازیابی است.
- بازخورد کاربر: در کنار هر پاسخ، امکان «مفید بود/مفید نبود» یا فیلد توضیح کوتاه فراهم شود. این بازخوردها در پایش دورهای استفاده میشوند تا نمونههای مشکلدار شناسایی شوند.
- آزمون آفلاین: برای
انتخاب و پیادهسازی RAG در وردپرس
معیارهای انتخاب افزونه RAG برای وردپرس
در انتخاب یک راهکار RAG برای وردپرس، تصمیمگیری صرفاً به ظاهر افزونه محدود نمیشود. لازم است بر اساس نیازهای واقعی سایت، نوع محتوا و سطح منابع، معیارهای دقیق تعریف شود تا پیادهسازی پایدار و قابلگسترش باشد.
مهمترین معیارها را میتوان در چند محور اصلی دستهبندی کرد:
نوع و حجم محتوای سایت: اگر سایت دارای مقالات طولانی، اسناد فنی، راهنماهای محصول یا دیتابیس بزرگ است، افزونه باید امکان ایندکسکردن تدریجی، بهروزرسانی خودکار و پشتیبانی از انواع پستتایپها (نوشته، برگه، محصولات ووکامرس و …) را فراهم کند.
یکپارچگی با مدل هوش مصنوعی: افزونه باید بهروشنی مشخص کند از چه مدلهای زبانی و سرویسهای امبدینگ پشتیبانی میکند؛ مثلاً اتصال به API مدلهای ابری، یا استفاده از مدلهای متنباز روی سرور. عدم شفافیت در این بخش، بهمرور باعث قفلشدن (Vendor Lock-in) و محدودیت توسعه میشود.
پشتیبانی از زبان فارسی: در سایتهای فارسی، کیفیت امبدینگ و بازیابی وابسته به مدلهای سازگار با زبان فارسی است. افزونه باید امکان انتخاب مدل یا سرویسهایی را فراهم کند که برای زبان فارسی بهینه شدهاند، وگرنه خروجی RAG حتی با محتوای قوی نیز ناکارآمد خواهد بود.
قابلیت کنترل و تنظیمات پیشرفته: امکان تعریف فیلترهای بازیابی (بر اساس دسته، برچسب، نوع محتوا)، تنظیم طول پاسخ، تنظیم لحن، و مدیریت پرامپتهای پایه، جزء الزامات یک افزونه حرفهای RAG است.
امنیت و حریم خصوصی: افزونه باید مشخص کند چه دادههایی به سرویسهای خارجی ارسال میشود و چه دادههایی روی سرور ذخیره میماند. برای سایتهایی با داده حساس (مانند پرتالهای مشتری، اسناد داخلی، یا دادههای مالی)، نیاز به امکان تفکیک و محدودسازی دادهها وجود دارد.
گزارشگیری و لاگ: برای بهبود مستمر RAG، افزونه باید امکان ثبت لاگ پرسشها، اسناد بازیابیشده و پاسخها را در سطحی کنترلشده فراهم کند؛ بدون این لاگها، تنظیم و اصلاح معماری بازیابی عملاً ممکن نیست.
تجربه کاربری و UI: افزونه باید رابط کاربری شفاف برای مدیر سایت داشته باشد؛ شامل داشبورد وضعیت ایندکس، صفبندی محتوا، خطاهای اتصال به مدل، و ابزار تست پرسشوپاسخ در محیط مدیریت وردپرس.
بر این اساس، توصیه میشود پیش از انتخاب افزونه، یک لیست نیازمندی اختصاصی برای سایت تهیه شود و افزونههای موجود بر اساس این معیارها ارزیابی شوند، نه صرفاً بر اساس تعداد نصب یا ظاهر دمو.
یکپارچهسازی با محتوای پویا و کاربران
در سایتهای وردپرسی، بخش مهمی از ارزش RAG زمانی آشکار میشود که این سیستم تنها روی محتوای ثابت (مقالهها و برگهها) متکی نباشد، بلکه با محتوای پویا و رفتار کاربران نیز همگام شود.
برای رسیدن به یکپارچگی پایدار، چند نکته کلیدی وجود دارد:
- پوشش همه انواع محتوا: افزونه RAG باید امکان ایندکسکردن انواع پستتایپها را داشته باشد؛ از جمله:
- نوشتهها و برگهها
- محصولات ووکامرس و ویژگیهای آنها
- پایگاه دانش، مستندات و سوالات متداول
- محتوای پلاگینهای سفارشی (مانند دورههای آموزشی، اسناد فنی یا تیکتها)
بهروزرسانی خودکار با تغییر محتوا: در معماری RAG، انسجام بین محتوا و امبدینگ حیاتی است. افزونه باید هنگام افزودن، ویرایش یا حذف محتوا، عملیات بهروزرسانی امبدینگ و ایندکس را بهصورت خودکار یا با صفبندی انجام دهد تا پاسخها با آخرین نسخه محتوا هماهنگ باشند.
- یکپارچگی با سیستم کاربری: در سایتهایی که سطح دسترسی وجود دارد (عضویت، نقشهای کاربری، محتوای خصوصی)، سامانه RAG نباید محتوای محرمانه را در پاسخ کاربران عمومی نمایش دهد. افزونه باید:
- دسترسی به اسناد را بر اساس نقش کاربری کنترل کند.
- در فرآیند بازیابی، تنها اسنادی را در نظر بگیرد که کاربر مجوز مشاهده آنها را دارد.
- امکان تعریف context بر اساس پروفایل کاربر (زبان، سطح عضویت، سابقه خرید) را فراهم کند.
- تعامل با فرمها و چتباتها: پیادهسازی RAG اغلب در قالب چتبات یا ویجت پرسشوپاسخ روی سایت انجام میشود. افزونه باید بهگونهای طراحی شود که:
- با افزونههای فرمساز (مانند فرم تماس یا تیکتینگ) قابلاتصال باشد.
- امکان ذخیره پرسشها در پایگاه داده وردپرس را داشته باشد تا برای تحلیل و بهبود استفاده شود.
- در صورت نیاز، بتواند پاسخها را در کنار پاسخهای سنتی (FAQ) نمایش دهد تا کاربر در جریان منبع پاسخ باشد.
- مدیریت چندزبانه: در سایتهای چندزبانه، لازم است RAG بتواند:
- محتوا را بر اساس زبان تفکیک کند.
- سوالات هر زبان را با امبدینگ و مدل مناسب همان زبان پاسخ دهد.
- از اشتباه مهدیکردن محتواهای زبانهای مختلف در یک پاسخ جلوگیری کند.
این سطح از یکپارچگی باعث میشود RAG به یک ابزار صرفاً نمایشی تبدیل نشود، بلکه در مرکز تعامل کاربر با سایت قرار گیرد و بخشی از تجربه کاربری روزمره باشد.
مدیریت منابع و هزینه در سایتهای وردپرسی
پیادهسازی RAG در وردپرس، علاوه بر طراحی منطقی و فنی، نیازمند برنامهریزی دقیق برای مدیریت منابع (CPU، حافظه، پهنای باند) و کنترل هزینهها است؛ بهویژه زمانی که از سرویسهای ابری مدلهای بزرگ زبانی استفاده میشود.
برای مدیریت پایدار منابع و هزینه، چند محور مهم وجود دارد:
- انتخاب بین مدل ابری و مدل محلی:
در مدلهای ابری، هزینه معمولاً بهصورت
آینده RAG و روندهای جدید در هوش مصنوعی وب
ترکیب RAG با عاملها و اتوماسیون
جهتگیری آینده RAG بهصورت واضح به سمت ترکیب با عاملهای هوشمند (AI Agents) و سیستمهای اتوماسیون است. تا امروز، RAG بیشتر شبیه یک «ماژول پاسخگو» عمل میکند؛ یعنی ورودی را میگیرد، اسناد مرتبط را بازیابی میکند و با مدل زبانی پاسخ تولید میکند. در نسل بعد، این رویکرد به سمت RAG عاملمحور حرکت میکند؛ جایی که RAG فقط پاسخ نمیدهد، بلکه اقدام هم انجام میدهد.
در این مدل جدید، یک عامل هوشمند میتواند:
- با استفاده از RAG پرسوجوهای کاربر را در کانتکست سایت تحلیل کند،
- دادههای مرتبط را از چند منبع (پایگاهداده، API، محتواهای سایت) بازیابی کند،
- و سپس اقدامهایی مثل ثبت تیکت، ایجاد پیشنویس محتوا، بهروزرسانی یک گزینه تنظیمات یا حتی راهاندازی یک گردشکار اتوماسیون را انجام دهد.
در وب و مخصوصاً وردپرس، این ترکیب بهمعنای چتباتهایی است که فقط پاسخ نمیدهند، بلکه کار انجام میدهند. مثالها:
- در سایت فروشگاهی: عامل مبتنی بر RAG بر اساس تاریخچه سفارش و مستندات سیاست مرجوعی، درخواست کاربر را تحلیل کرده و بهصورت خودکار درخواست مرجوعی را در ووکامرس ثبت میکند.
- در سایت آموزشی: عامل بر اساس مطالب دورهها و پیشرفت کاربر، برنامه مطالعه پیشنهاد میدهد و رویدادهای مربوط را در تقویم کاربر ثبت میکند.
در آینده نزدیک، افزونههای هوش مصنوعی وردپرس به سمت «کمکیار سایت» حرکت میکنند؛ یعنی یک عامل RAG که:
- محتوای سایت را میشناسد،
- به APIها و افزونهها دسترسی دارد،
- و میتواند بخشی از مدیریت سایت، پشتیبانی و تولید محتوا را اتوماسیون کند.
RAG چندمنبعی و چندمودالیته
یکی از روندهای مهم آینده، حرکت از RAG تکمنبعی متنمحور، به سمت RAG چندمنبعی (Multi-source) و چندمودالیته (Multimodal) است. در معماریهای سنتی RAG، ورودی و منابع دانش عمدتاً متنی هستند؛ اما وب مدرن مبتنی بر ترکیبی از متن، تصویر، ویدیو، صوت و داده ساختیافته است.
RAG چندمنبعی و چندمودالیته تلاش میکند:
- چند نوع داده (متن، تصویر، ویدیو، صوت) را همزمان در فرآیند بازیابی وارد کند،
- از چند منبع مستقل (پایگاهداده وردپرس، فایلهای PDF، مستندات API، لاگها، CRM و …) استفاده کند،
- و در نهایت پاسخ تولیدشده را بر اساس ترکیب این کانتکستها بسازد.
در حوزه وب و وردپرس، این تغییر در عمل به چه معناست؟
- یک RAG میتواند همزمان از محتوای پستها و برگهها، از فایلهای مستندات (PDF، DOCX)، از دادههای محصول در ووکامرس و از گزارشهای پشتیبانی اطلاعات بازیابی کند.
- برای سایتهایی که ویدیو و پادکست دارند، ترنسکریپت این محتواها هم بهعنوان منبع RAG وارد میشود.
- با گسترش مدلهای Multimodal LLM، RAG میتواند حتی از اطلاعات تصاویر (مثلاً اسکرینشات پنل تنظیمات یا نمودارها) هم استفاده کند.
چالش اصلی در این مسیر، طراحی لایهای از اتحاد داده است که بتواند:
- انواع مختلف داده را به فضای امبدینگ مشترک منتقل کند،
- شاخصهای جستوجو را برای هر نوع داده بهینه نگه دارد،
- و در نهایت، کانتکست مناسب را متناسب با نوع سوال کاربر انتخاب کند.
در وردپرس، افزونههای آینده RAG بهسمت داشبوردهای یکپارچه مدیریت دانش میروند؛ جایی که مدیر سایت میتواند چند منبع را تعریف، اولویتبندی و به مدل معرفی کند؛ بدون نیاز به پیادهسازیهای پیچیده اختصاصی.
جایگاه RAG در محصولات تجاری و افزونهها
در فاز بعدی تحول وب، RAG تبدیل به یک ویژگی لوکس نخواهد بود، بلکه به یک قابلیت استاندارد در محصولات تجاری و افزونهها تبدیل میشود. کاربردهای اولیه بیشتر بهصورت «افزودنی هوشمند» یا «ویژگی نسخه پرمیوم» ارائه شدهاند؛ اما روند بازار به سمت ادغام عمیقتر و «هوش تعبیهشده» در هسته محصولات پیش میرود.
در محصولات SaaS، پلتفرمهای وب و افزونههای وردپرس، چند مسیر مشخص برای جایگاه RAG در حال شکلگیری است:
- RAG بهعنوان لایه پشتیبان مستندات: بخش راهنما، مستندات و پایگاهدانش دیگر فقط مجموعهای از صفحات نیست؛ بلکه توسط یک موتور RAG تغذیه میشود که توضیح میدهد، مثال میزند و حتی دستورکار عملی ارائه میکند.
- RAG بهعنوان موتور جستوجوی داخلی: در آینده نزدیک، جستوجوی سنتی وردپرس (بر اساس کوئری SQL) در بسیاری از سایتها جای خود را به جستوجوی معنایی مبتنی بر RAG میدهد؛ جستوجویی که قصد کاربر را میفهمد و پاسخ ترکیبی ارائه میکند.
- RAG بهعنوان لایه هوش تجاری (BI) سبک: در سایتهای فروشگاهی، خبری و عضویتی، RAG میتواند گزارشها و تحلیلها را بر اساس دادههای تاریخی سایت تولید کند؛ بدون آنکه مدیر سایت مجبور به ساخت کوئریهای پیچیده باشد.
برای اکوسیستم وردپرس، این روند چند پیامد مهم دارد:
- افزونههای تخصصی (فروشگاهی، عضویت، LMS، فرمسازها) بهتدریج API یا هوکهایی برای اتصال به لایه RAG در سطح سایت ارائه خواهند داد.
- افزونههای هوش مصنوعی از نقش «چتبات عمومی» فاصله میگیرند و به سمت «موتور RAG مرکزی سایت» حرکت میکنند که چندین افزونه دیگر به آن متصل میشوند.
- مدیران سایتها در انتخاب افزونهها، معیار جدیدی خواهند داشت: سازگاری با RAG و مدلهای زبانی. افزونهای که بتواند دادههای خود را بهطور استاندارد در اختیار موتور RAG قرار دهد، مزیت رقابتی خواهد داشت.
در نهایت، آینده RAG در وب و وردپرس